一個人用 AI 做動畫,配音、角色、對嘴每一關都卡
我用 AI 做了一隻自創的 3D 哥布林,想讓他演上班族和情侶的日常短片。第一支走完整個流程的〈待辦清單之神〉,每一關都卡:
- 配音:要找有台灣口音又有卡通感的中文聲音,可是能商用的中文聲線,常常一開口就是中國腔。我試了 194 個音檔,才定下 10 句配音。
- 角色:哥布林是我自創的,皮膚和頭髮的質感、整體材質都要一張一張調,13 張分鏡圖前後退掉 28 張才定稿。
- 對嘴:角色開口講話,嘴型得跟聲音對上,我試了好幾個工具才定下來。
光這一支片,有記下來的工時就超過 20 小時。
一支片從 20 多小時縮到 3.5 小時,一週能做 3、4 支
9 月中的〈要不要香菜〉,同樣從劇本一路做到發布,只花了約 3.5 小時,一個早上就做完。時間省在哪裡,對照這張表:
| 8 月初〈待辦清單之神〉 | 9 月中〈要不要香菜〉 | |
|---|---|---|
| 總工時 | 超過 20 小時,跨了 6 天 | 約 3.5 小時,一個早上 |
| 劇本和分鏡腳本 | 分鏡腳本改了 10 版 | 劇本改兩輪,分鏡腳本一輪就過 |
| 畫面 | 13 張分鏡圖一張張定稿,花了 8 小時 | 兩張故事板,其中一張重生一次 |
| 配音 | 選聲線加配音,花了 6.7 小時 | 聲線早就定好,直接配 |
| 生影片 | 生影片的指令改了 8 版 | 兩段各生一次,沒有補任何一鏡 |
現在只要我有上工、沒有休假去玩,一個禮拜做 3、4 支都不是問題。
先把故事定案,用一張故事板生整段影片,哪裡壞了補哪裡
以前我把每個鏡頭先畫成一張定稿的圖,再一張張拿去生影片,大部分時間都卡在讓圖跟指令對上。現在改成一張圖生一整段,壞了再補。整條流程裡,我跟 AI 這樣分工:
- AI 負責:寫劇本和分鏡腳本的草稿,畫故事板,寫生影片的指令,配音,上字幕,排程發文。
- 我負責:每一站拍板,把指令拿去生影片,最後自己剪輯。
總共五步:
| 步驟 | 做什麼 | 用什麼工具 |
|---|---|---|
| 1. 劇本和分鏡腳本先定案 | 寫好故事,拆成每一鏡的秒數、畫面和臺詞 | Claude Code,網頁版的 Claude 或 ChatGPT 也可以 |
| 2. 先配音,再排秒數 | 配好臺詞,照實際長度改每一鏡的秒數 | ElevenLabs |
| 3. 一段畫一張故事板 | 把每個鏡頭畫在同一張圖上,一張最多 15 秒 | Claude Code 叫 OpenAI 生圖,網頁版用 ChatGPT |
| 4. 故事板和配音一起生影片 | 整張故事板加上音檔,丟給影片模型 | Dreamina |
| 5. 哪裡壞了補哪裡 | 只重畫壞的格子,只重生壞的鏡頭,再剪輯 | 剪映 |
第一步:劇本和分鏡腳本先定案
- 做什麼:劇本決定故事和笑點,分鏡腳本把它拆成每一鏡的秒數、畫面、動作和臺詞。
- 為什麼先定案:圖和影片一生下去就要花錢,故事到那時候才改,前面全部白費。
- 怎麼算過關:只看文字就覺得好看,鏡頭數、秒數和臺詞都不再改。
- 畫面不放字:要讓觀眾看到的字,改成臺詞講出來,AI 畫出來的中文字幾乎都會壞。
網頁版的 Claude 或 ChatGPT 可以這樣起頭:
我想做一支 20 秒左右的 9:16 直式動畫短片,主角是(角色),故事是(一句話大綱)。
請先寫劇本,標出笑點落在哪。我確認後,再拆成分鏡腳本,每一鏡寫秒數、畫面、動作和臺詞。
畫面裡不要出現文字,要讓觀眾知道的數字或字,改成臺詞講出來。
劇本和分鏡腳本的細節寫在 No.22。
第二步:先配音,再照聲音長度排秒數
- 做什麼:用 ElevenLabs(打字就能用固定聲音念出來的 AI 配音工具)把臺詞配好,再回頭改每一鏡的秒數。
- 為什麼先配音:〈待辦清單之神〉我先排秒數才配音,規劃 17 秒,配出來 29.8 秒,整支只好重排。
- 怎麼算過關:每一鏡的秒數,跟實際配音的長度對得上。
- 聲線選一次就好:之後每支片都用同一個聲音,怎麼選寫在 No.20。
第三步:一段畫一張故事板,最多 15 秒
故事板是把一段影片的每個鏡頭畫在同一張圖上,像漫畫一樣一格一格排好,每格上方寫鏡號、秒數和臺詞。
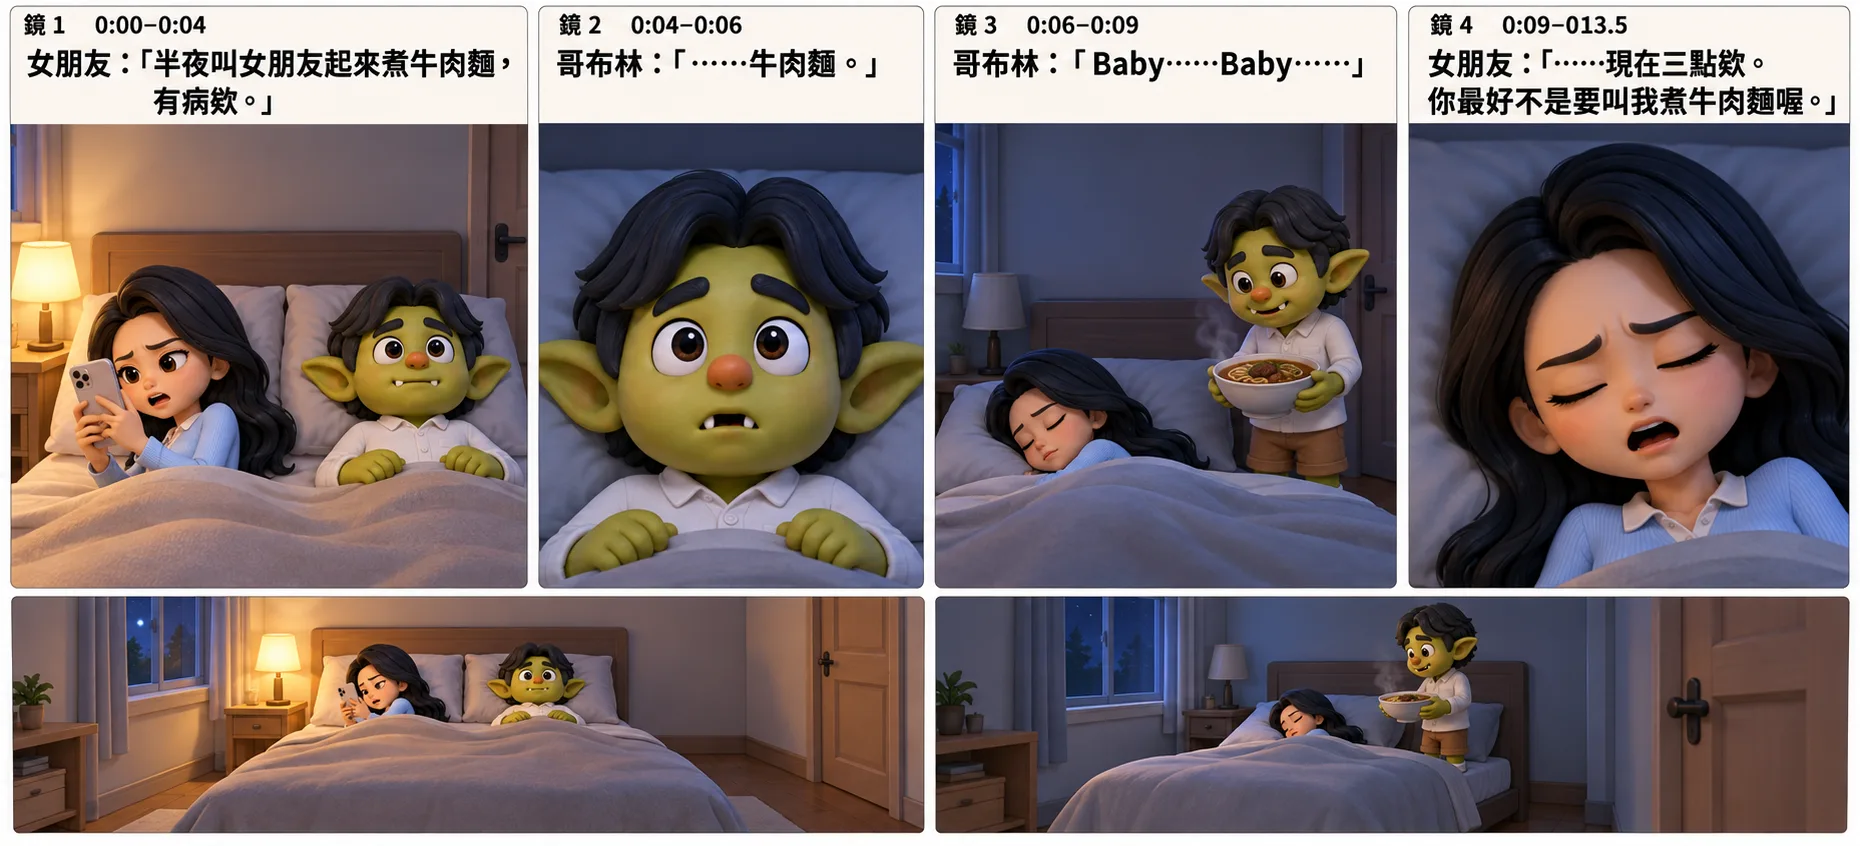
- 為什麼畫在同一張:角色和房間比較不會一格一個樣。
- 為什麼最多 15 秒:影片模型一次最多生 15 秒,比較長的片就在換場的地方拆段,一段一張。〈玉蘭花〉我把 18 秒的內容硬塞進一次生成,畫面全都快速帶過,臺詞也黏在一起。
- 怎麼生:我讓 Claude Code 透過 Codex(OpenAI 的 AI 助手)直接叫 OpenAI 的生圖模型畫,走原本的 ChatGPT 訂閱,不用另外付費,畫好它會先逐格檢查。用網頁版的話,把指令和角色圖卡一起貼進 ChatGPT 就好。
- 怎麼算過關:格子是直的,不是方的;每一格的角色、道具和方位都對;圖上的臺詞逐字對。
指令最容易漏三件事:
- 角色照圖卡畫,不用文字形容長相:文字再描述一次,模型會在圖和文字之間混出第三種長相。圖卡怎麼做寫在 No.21。
- 每格寫明 9:16 直式,高度約寬度的 1.8 倍:格子畫成方的,影片模型會自己把畫面推近,臉就跟著爛掉。上面這張就偏方,我只好在影片指令每一鏡加上「鏡頭不要推近」。
- 房間的東西寫明在哪一邊:〈要不要香菜〉第一版只寫有床、檯燈、房門,沒寫位置,四格的檯燈和房門各畫各的。
請幫我畫一張故事板,用來生成一段 13 秒的 9:16 直式短影片。
附圖是角色的定位圖卡,長相完全照圖,不要重新設計、不要美化。
版型:上排一列 4 格,每格上方寫鏡號、秒數和臺詞,下方是 9:16 直式畫面,畫面高度約為寬度的 1.8 倍。下排 2 格畫房間全景,交代誰在哪裡。整張大約 1.4:1 橫式,寧可留白,也不要壓縮格子。
場景:(房間有什麼,各在哪一邊,每一格都一樣)
鏡 1 0:00–0:04:(遠景或近景、角色在做什麼、什麼表情)臺詞:「⋯⋯」
鏡 2 0:04–0:06:⋯⋯
不要加箭頭、說明文字或浮水印。
第四步:故事板和配音一起丟給影片模型
- 用什麼:Dreamina 是 TikTok 母公司字節跳動的 AI 影片平台,裡面的 Seedance 2.0 模型能同時讀圖片和聲音。
- 上傳什麼:整張故事板和音檔,再寫一段指令交代鏡頭怎麼動、動作的先後和音效,圖上看得到的不用重寫。
- 為什麼帶配音:模型會照音檔的節奏講臺詞,嘴型就對得上,我以前最卡的對嘴就這樣解決。
- 怎麼算過關:生出來逐秒對照故事板,同一鏡重生兩次還是壞,就停下來找原因,不一直抽。
第五步:哪裡壞了補哪裡,再剪輯
- 故事板壞一兩格:只重畫那一格貼回去。整張重生常常改好一格,又壞了另一格。
- 影片壞一鏡:拿那一鏡的圖,只重生那幾秒,不用整段重來。
- 圖本身就錯:先回去修圖,不靠影片指令的文字去救。
- 剪輯和發布:我用剪映剪,AI 上中英字幕,排程發 IG。
適合自己的工作流,要自己做過才找得到
每個人的創作風格不同,喜歡的工具也不一樣。這五步是我試了很久,做了 20 幾支才建立的工作流,不一定適合你,但唯有真正去做,你才會知道自己卡在哪裡,適合自己的工作流長什麼樣子。